Intégrer un assistant vocal IA en temps réel dans une application web : architecture, latence, coûts et code
- Un assistant vocal IA enchaîne cinq étapes : capter le micro, détecter la fin de la phrase, transcrire, générer la réponse et la prononcer.
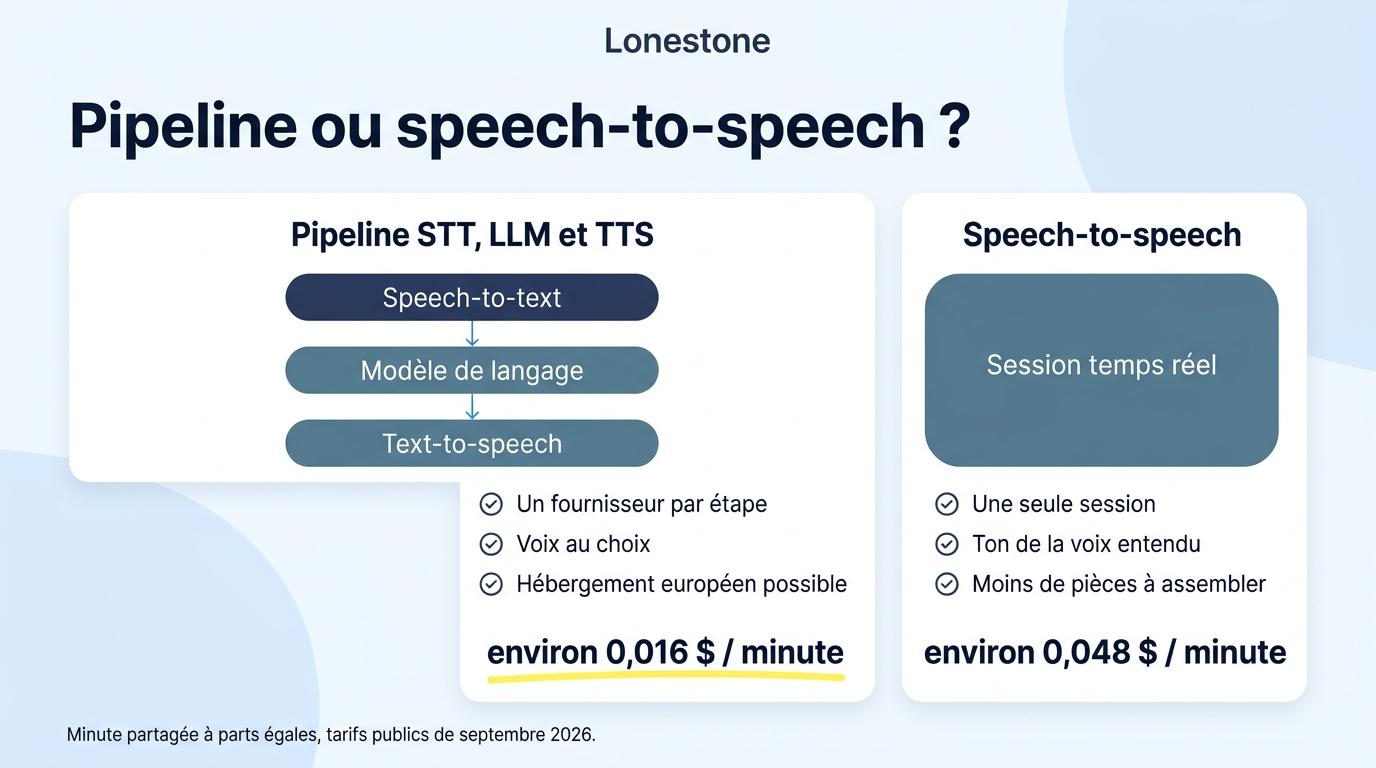
- Un pipeline STT, LLM et TTS coûte jusqu’à trois fois moins cher à la minute qu’un modèle speech-to-speech et laisse choisir chaque fournisseur.
- L’attente du silence en fin de phrase pèse souvent plus lourd dans la latence que le modèle de langage lui-même.
- Quand l’utilisateur interrompt l’assistant, coupez le son, annulez la génération et gardez dans l’historique uniquement ce qu’il a entendu.
- La voix est une donnée personnelle : gardez les clés API côté serveur et choisissez des fournisseurs européens ou des modèles locaux quand les données sont sensibles.
Un assistant vocal IA en temps réel écoute l’utilisateur au micro, comprend sa demande et lui répond à voix haute, avec un délai assez court pour que l’échange ressemble à une conversation. Pour l’intégrer dans une application web, deux architectures existent : un pipeline qui enchaîne transcription (speech-to-text), modèle de langage et synthèse vocale (text-to-speech), ou un modèle speech-to-speech qui entend et répond dans une seule session. Le pipeline reste le choix par défaut en production : il coûte jusqu’à trois fois moins cher à la minute et laisse choisir la voix, la langue et l’hébergement. Le modèle speech-to-speech demande moins de pièces à assembler et entend le ton de la voix. Ce guide détaille aussi la latence, la gestion des interruptions, les permissions micro, les erreurs réseau, la confidentialité et les coûts, avec des exemples de code en TypeScript.
Comment fonctionne un assistant vocal IA en temps réel ?
Chaque tour de parole traverse cinq étapes, du navigateur au serveur puis retour :
- Le navigateur capte le micro et envoie l’audio au serveur par petits morceaux, pendant que l’utilisateur parle.
- Un détecteur d’activité vocale (VAD, pour voice activity detection) repère le début et la fin de la phrase.
- Un moteur de speech-to-text transcrit la phrase, idéalement en streaming, au fil de l’eau.
- Un modèle de langage (LLM) génère la réponse et appelle si besoin des outils : une base de données, une API métier, un agenda.
- Un moteur de text-to-speech transforme la réponse en voix, que le navigateur joue dès les premiers morceaux reçus.
graph TD
  A[Micro du navigateur] --> B[Détection de la voix]
  B --> C[Transcription speech-to-text]
  C --> D[Modèle de langage et outils]
  D --> E[Synthèse vocale text-to-speech]
  E --> F[Lecture dans le navigateur]
  F -.->|L’utilisateur reprend la parole| B
Le temps réel tient au streaming. L’audio part vers le serveur pendant que l’utilisateur parle, la transcription avance en même temps, et la voix commence dès que le modèle a écrit sa première phrase. Un système qui attend la fin de chaque étape pour lancer la suivante ajoute plusieurs secondes de silence à chaque échange.
Un modèle speech-to-speech, comme l’API Realtime d’OpenAI ou Gemini Live, remplace les étapes 3 à 5 par une seule session : il reçoit l’audio et renvoie de l’audio. Le micro, la détection de la voix et la lecture restent à la charge de l’application.
Pipeline STT, LLM et TTS ou modèle speech-to-speech ?
Le choix d’architecture se fait sur trois critères : le prix à la minute, la liberté de choisir chaque fournisseur, et l’importance du ton de la voix dans le produit.
Un modèle speech-to-speech entend l’audio brut. Une hésitation, un rire ou une intonation ironique lui parviennent, alors qu’une transcription les transforme en texte plat. Pour un outil d’apprentissage des langues ou de coaching oral, cette écoute fait partie du produit. Le modèle répond aussi un peu plus vite, puisqu’il n’attend pas une transcription finale.
Un pipeline sépare les trois fonctions. Vous prenez la transcription la plus fiable en français, le LLM qui appelle le mieux vos outils et la voix qui correspond à votre marque. Si un fournisseur tombe en panne, un autre prend le relais sur cette seule étape. La transcription existe dès le départ, ce qui simplifie les journaux, les évaluations et l’archivage.
| Critère | Pipeline STT, LLM et TTS | Modèle speech-to-speech |
|---|---|---|
| Fournisseurs | Un par étape, interchangeable | Un seul pour tout |
| Voix disponibles | Tout le catalogue du fournisseur TTS, clonage compris | La liste du modèle |
| Ton et hésitations | Perdus à la transcription | Entendus par le modèle |
| Facturation | Par étape, au tarif de chacune | Tokens audio sur toute la durée |
| Panne d’un fournisseur | Bascule sur un second fournisseur pour l’étape touchée | Toute la conversation s’arrête |
| Hébergement 100 % européen | Possible avec des fournisseurs européens | Impossible avec un fournisseur américain |
| Transcription | Produite à chaque tour | À reconstituer depuis les événements de session |
| Pièces à assembler | Trois services à orchestrer | Une session |
L’écart de prix vient de la facturation en tokens audio. Selon la grille tarifaire d’OpenAI relevée en septembre 2026, le modèle gpt-realtime-2.1 coûte 32 $ par million de tokens audio en entrée et 64 $ en sortie. Un token correspond à 100 ms d’audio entendu et à 50 ms d’audio prononcé. Une minute partagée à parts égales entre l’utilisateur et l’assistant représente donc 300 tokens en entrée et 600 en sortie, soit environ 0,048 $. Le même calcul fait étape par étape donne environ 0,016 $ la minute avec de petits modèles OpenAI et 0,027 $ avec une chaîne européenne (Gladia pour la transcription, Mistral pour le modèle, Gradium pour la voix). La voix premium est l’étape la plus chère d’un pipeline, ce qui explique l’écart entre ces deux chaînes.
À la minute, ces prix restent faibles. Sur 10 000 minutes par mois, la facture atteint environ 480 $ en speech-to-speech contre 160 $ en pipeline sur petits modèles. Les conversations longues creusent l’écart, car les deux architectures renvoient tout l’historique à chaque tour, en tokens texte pour le pipeline et en tokens audio pour la session temps réel. Estimez la facture de votre propre volume avec le simulateur de coûts IA.
Où part la latence d’un tour de parole ?
Une conversation entre humains laisse très peu de silence. En 2009, la linguiste Tanya Stivers, alors à l’Institut Max-Planck de psycholinguistique, et ses collègues ont mesuré la prise de parole dans dix langues et publié les résultats dans PNAS (Stivers et al., 2009). Dans toutes ces langues, les interlocuteurs évitent de se chevaucher et laissent le moins de silence possible entre deux tours. La moyenne de chaque langue reste à environ 250 ms de la moyenne générale. Un assistant qui met deux secondes à répondre paraît donc lent, même si sa réponse est juste.
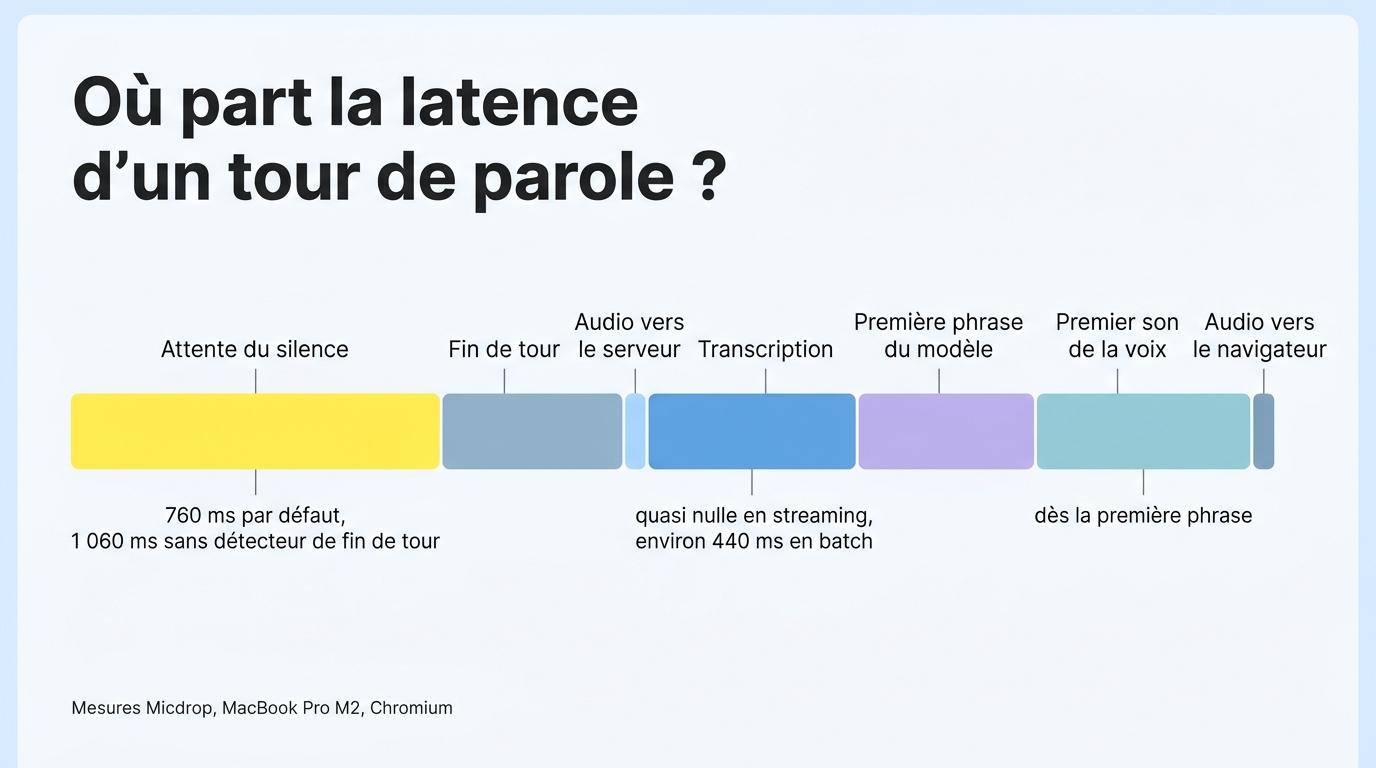
Le délai entre le dernier mot de l’utilisateur et le premier mot de l’assistant se décompose ainsi :
| Étape | Durée fixée par | Levier principal |
|---|---|---|
| Attente du silence | Le temps que le détecteur de voix attend avant de clore la phrase | Ajouter un détecteur de fin de tour pour raccourcir l’attente |
| Fin de tour | Un modèle qui juge si la phrase est finie, s’il y en a un | Le faire tourner sur la carte graphique du poste |
| Audio vers le serveur | Un aller simple sur le réseau, l’audio étant envoyé pendant la phrase | Peu de marge sur une connexion saine |
| Transcription | Batch ou streaming | Passer à une transcription en streaming |
| Première phrase du modèle | Le modèle, la longueur du prompt, les appels d’outils | Un modèle rapide, un prompt court, des outils limités |
| Premier son de la voix | Le fournisseur TTS | Synthétiser phrase par phrase |
| Audio vers le navigateur | Réseau et tampon de lecture | Peu de marge sur une connexion saine |
L’attente du silence surprend le plus. Un détecteur de voix ne sait pas qu’une phrase est terminée, il attend quelques centaines de millisecondes de silence pour en être sûr. Micdrop a mesuré ses réglages sur un MacBook Pro M2 dans Chromium : par défaut, ils clôturent une phrase en 760 ms, contre 1 060 ms avec les anciens réglages, parce qu’un modèle de détection de fin de tour juge si la phrase est finie. Ce gain de 300 ms se paie en précision : la fin de phrase est bien détectée dans 86,7 % des tours mesurés, contre 90,8 % avec les anciens réglages.
La transcription est le deuxième poste de latence. Un modèle batch comme Whisper attend que la phrase soit close pour démarrer, puis met environ 440 ms à transcrire une phrase de trois secondes, selon la même documentation. Un modèle en streaming comme celui de Gladia transcrit pendant que l’utilisateur parle, si bien que le texte est presque prêt quand l’utilisateur se tait.
Trois habitudes réduisent ensuite le délai davantage que le choix du modèle :
- garder les modèles chargés entre deux appels et lancer un appel de chauffe au démarrage
- envoyer la première phrase à la synthèse vocale dès qu’elle existe, sans attendre la réponse complète
- limiter les appels d’outils automatiques, car un second passage dans le LLM ajoute plus de délai que la transcription et la voix réunies.
WebSocket ou WebRTC pour le streaming audio web ?
Pour un navigateur qui parle à votre serveur, une WebSocket suffit. Elle passe par les mêmes proxys et pare-feu que votre trafic HTTPS, votre serveur identifie l’utilisateur comme pour le reste de l’application, et chaque message apparaît dans l’onglet Réseau des outils de développement. Sur une connexion saine, le réseau ne représente que quelques dizaines de millisecondes sur l’ensemble du tour.
WebRTC envoie l’audio en UDP, compressé avec le codec Opus, et saute un paquet perdu plutôt que d’attendre qu’il soit renvoyé. En contrepartie, il demande un serveur de signalisation, des serveurs STUN et TURN, souvent un serveur média, et des ports UDP ouverts. WebRTC se justifie dans quatre cas :
- un appel à plus de deux participants, par exemple un utilisateur, un agent et un collègue
- des appels qui arrivent du réseau téléphonique
- un agent qui envoie aussi de la vidéo
- des utilisateurs sur des réseaux mobiles faibles, où le renvoi des paquets perdus par TCP s’entend comme un bégaiement.
Surveillez aussi la bande passante : l’audio brut en 16 bits à 16 kHz pèse 256 kbit/s, plusieurs fois plus que l’Opus de WebRTC. Avec une WebSocket, n’envoyez l’audio que pendant que l’utilisateur parle, grâce au détecteur de voix du navigateur.
Comment gérer les interruptions de l’utilisateur ?
Un assistant qui continue de parler quand on lui coupe la parole ressemble à un répondeur. Une interruption se gère en cinq étapes, dans cet ordre :
- Détecter une vraie prise de parole pendant que l’assistant parle, ce qui suppose de garder le micro ouvert pendant la lecture.
- Couper le son tout de suite et vider l’audio déjà en file d’attente dans le navigateur.
- Annuler la génération du LLM et la synthèse vocale, ou ignorer les morceaux qui arrivent encore de la réponse interrompue.
- Continuer d’écouter l’utilisateur jusqu’à la fin de sa phrase.
- Générer la réponse suivante à partir d’un historique qui contient seulement ce que l’utilisateur a entendu.
Le tri de l’historique est l’étape la plus souvent oubliée. Le modèle a parfois écrit un paragraphe entier alors que l’utilisateur n’en a entendu que la première phrase. Si l’historique garde tout, la réponse suivante fait référence à des informations jamais prononcées. L’API Realtime d’OpenAI propose pour cela de tronquer la partie non entendue d’une réponse. Dans un pipeline, enregistrez la progression de la lecture ou un marqueur d’interruption avec chaque message.
L’écho complique la détection. Le micro entend aussi la voix de l’assistant qui sort des haut-parleurs. Sans annulation d’écho, l’assistant s’interrompt donc lui-même. Une toux, une porte qui claque ou un « mm-hm » déclenchent aussi de fausses interruptions. Testez avec des enregistrements de vos vrais utilisateurs dans leur vrai environnement, et comptez séparément les arrêts injustifiés et les interruptions ratées.
Le navigateur ouvre le micro seulement en HTTPS et avec l’accord de l’utilisateur
L’accès au micro passe par getUserMedia(), qui ne fonctionne qu’en contexte sécurisé. D’après la documentation MDN, une page servie en HTTP n’a même pas accès à navigator.mediaDevices. Seules les pages en HTTPS et localhost y ont droit, ce qui piège souvent les tests sur un téléphone pointé vers l’adresse IP d’un poste de développement.
Le navigateur demande l’autorisation au moins la première fois. Trois erreurs reviennent souvent :
| Erreur | Cause | Réponse dans l’interface |
|---|---|---|
NotAllowedError | L’utilisateur a refusé, ou la page n’est pas en HTTPS | Expliquer comment réautoriser le micro dans le navigateur |
NotFoundError | Aucun micro disponible | Proposer de brancher un micro ou de passer à l’écrit |
NotReadableError | Le micro est pris par une autre application ou en panne | Demander de fermer l’application qui l’utilise |
MDN signale un piège de plus : la promesse peut ne jamais se résoudre si l’utilisateur ignore la demande. Prévoyez un délai d’attente et un message. Demandez aussi le micro au moment où l’utilisateur clique sur le bouton d’appel, quand il comprend pourquoi la demande apparaît. Une demande affichée au chargement de la page se fait souvent refuser.
Erreurs réseau et reconnexion
Une conversation vocale dure plusieurs minutes, souvent sur un téléphone qui change de réseau. Prévoyez trois cas :
- si la connexion tombe en cours d’appel, le client se reconnecte sans perdre l’historique
- si un fournisseur (transcription, LLM ou voix) répond en erreur ou trop lentement, le serveur réessaie ou bascule sur un autre
- si l’authentification échoue, l’interface invite l’utilisateur à se reconnecter plutôt qu’à vérifier son micro.
Affichez l’état de l’appel à l’écran : connexion, écoute, réflexion, réponse, reconnexion. Un utilisateur qui voit « reconnexion en cours » attend, alors qu’un silence sans explication le pousse à raccrocher.
Confidentialité, RGPD et souveraineté
La voix est une donnée personnelle. Dans son livre blanc sur les assistants vocaux, « À votre écoute » publié en septembre 2020, la CNIL rappelle que la voix permet d’identifier une personne et recommande de régler les dispositifs par défaut sur leur fonctionnement le plus protecteur de la vie privée. Quatre décisions en découlent :
- gardez les clés API des fournisseurs sur votre serveur, jamais dans le navigateur, et faites transiter l’audio par votre backend
- décidez si vous conservez l’audio, la transcription ou aucun des deux, pour quelle durée, et dites-le à l’utilisateur
- vérifiez où chaque fournisseur traite les données et ce qu’il en garde
- pour des données sensibles (santé, RH, juridique), montez une chaîne entièrement européenne, avec par exemple Gladia ou Mistral pour la transcription, Mistral pour le modèle et Gradium pour la voix, ou faites tourner Whisper et Piper sur vos propres serveurs.
Un pipeline rend ces choix possibles étape par étape. Avec un modèle speech-to-speech américain, vous pouvez faire traiter les données sur des serveurs en Europe, mais par une entreprise qui reste américaine.
Exemple de code : un assistant vocal en français avec Micdrop
Micdrop est une bibliothèque open source en TypeScript, sous licence MIT, pour les conversations vocales temps réel avec une IA. Godefroy de Compreignac, CEO de Lonestone, l’a créée pour les besoins de Raconte, puis l’a publiée avec les autres projets open source de Lonestone. Elle se compose d’un paquet navigateur (@micdrop/web), d’un paquet serveur Node (@micdrop/server) et d’intégrations prêtes pour OpenAI, Gemini, Mistral, Gladia, ElevenLabs, Cartesia, Gradium et des modèles locaux. L’audio circule en WebSocket, le navigateur gère le micro, la détection de la voix et la lecture, et le serveur orchestre la transcription, l’agent et la voix.
Côté serveur, on monte une chaîne Mistral complète en français et on vérifie un jeton avant d’ouvrir l’appel. Les classes et les options viennent de la documentation du serveur Micdrop.
import {  MicdropServer,  MicdropError,  MicdropErrorCode,  waitForParams,  handleError,} from '@micdrop/server'import { MistralAgent, MistralSTT, MistralTTS } from '@micdrop/mistral'import { WebSocketServer } from 'ws'import { z } from 'zod'
const paramsSchema = z.object({  authorization: z.string().startsWith('Bearer '),})
const wss = new WebSocketServer({ port: 8081 })
wss.on('connection', async (socket) => {  try {    // Le client envoie ses paramètres avant que l’appel commence    const params = await waitForParams(socket, paramsSchema.parse)    const user = await verifyToken(params.authorization) // votre propre vérification    if (!user) {      throw new MicdropError(MicdropErrorCode.Unauthorized, 'Jeton invalide')    }
    new MicdropServer(socket, {      firstMessage: 'Bonjour, que puis-je faire pour vous ?',      agent: new MistralAgent({        apiKey: process.env.MISTRAL_API_KEY || '',        systemPrompt: 'Tu es l’assistant du service client. Réponds en français, en phrases courtes.',      }),      stt: new MistralSTT({ apiKey: process.env.MISTRAL_API_KEY || '' }),      tts: new MistralTTS({        apiKey: process.env.MISTRAL_API_KEY || '',        voiceId: 'voice_592', // Marie, voix française      }),    })  } catch (error) {    // Renvoie au client un code d’erreur exploitable, puis ferme l’appel    handleError(socket, error)  }})
Côté navigateur, le client démarre l’appel au clic, affiche l’état de la conversation et traduit chaque code d’erreur en message utile. Les options viennent de la documentation du client Micdrop.
import { Micdrop } from '@micdrop/web'
Micdrop.on('StateChange', (state) => {  if (state.isReconnecting) showStatus('Reconnexion en cours…')  else if (state.isUserSpeaking) showStatus('Je vous écoute')  else if (state.isProcessing) showStatus('Je réfléchis')  else if (state.isAssistantSpeaking) showStatus('Réponse en cours')})
Micdrop.on('EndCall', () => Micdrop.stop())
async function startCall(token: string) {  try {    await Micdrop.start({      url: 'wss://example.com/call',      params: { authorization: `Bearer ${token}` },      vad: ['volume', 'silero'],      reconnect: { maxAttempts: 10, delayMs: 500 },    })  } catch (error) {    switch (error.code) {      case 'Mic':        showError('Autorisez le micro dans votre navigateur pour parler à l’assistant.')        break      case 'Unauthorized':        showError('Votre session a expiré, reconnectez-vous.')        break      case 'Connection':        showError('Connexion impossible, vérifiez votre réseau.')        break      default:        showError('L’assistant est indisponible pour le moment.')    }  }}
Le serveur gère les interruptions : quand le navigateur détecte que l’utilisateur reprend la parole, il coupe la lecture, et le serveur annule l’agent et la synthèse en cours. Les fonctions verifyToken, showStatus et showError sont à écrire dans votre application. Pour passer d’un fournisseur à l’autre, remplacez une classe par une autre (GladiaSTT pour la transcription, ElevenLabsTTS pour la voix) sans toucher au client. Le même assistant fonctionne aussi dans une app iOS et Android avec le paquet @micdrop/react-native.
Quand une intégration vocale temps réel vaut-elle le coup ?
La voix demande plus de travail de conception qu’un chat écrit et coûte plus à la minute. Elle se justifie quand le clavier gêne ou quand parler est plus naturel qu’écrire :
- des utilisateurs sur le terrain, les mains occupées (maintenance, logistique, BTP, santé)
- des publics à l’aise à l’oral et moins à l’écrit, ou des parcours où un formulaire décourage
- des entretiens et des collectes de témoignages, où la conversation donne des réponses plus détaillées qu’un questionnaire
- des exercices où le ton compte, comme la formation commerciale ou l’apprentissage d’une langue
- l’accessibilité, pour des personnes qui ont du mal à utiliser un écran.
Lonestone a livré deux produits de ce type. Raconte mène des interviews clients à l’oral, relance selon les réponses et rédige ensuite le contenu. La cabine de recrutement Cibli guide des candidats à la voix pour créer leur CV en une dizaine de minutes, sans formulaire, sur du matériel embarqué choisi et testé par l’équipe.
À l’inverse, gardez l’écrit quand l’utilisateur doit relire, comparer ou copier une réponse (un tableau de chiffres, une référence produit), quand il travaille dans un open space, ou quand le volume d’usage rend le coût à la minute difficile à amortir. Une dictée vocale, qui transcrit sans répondre, couvre aussi beaucoup de besoins pour bien moins cher qu’un assistant complet.
Les pièges d’implémentation à éviter
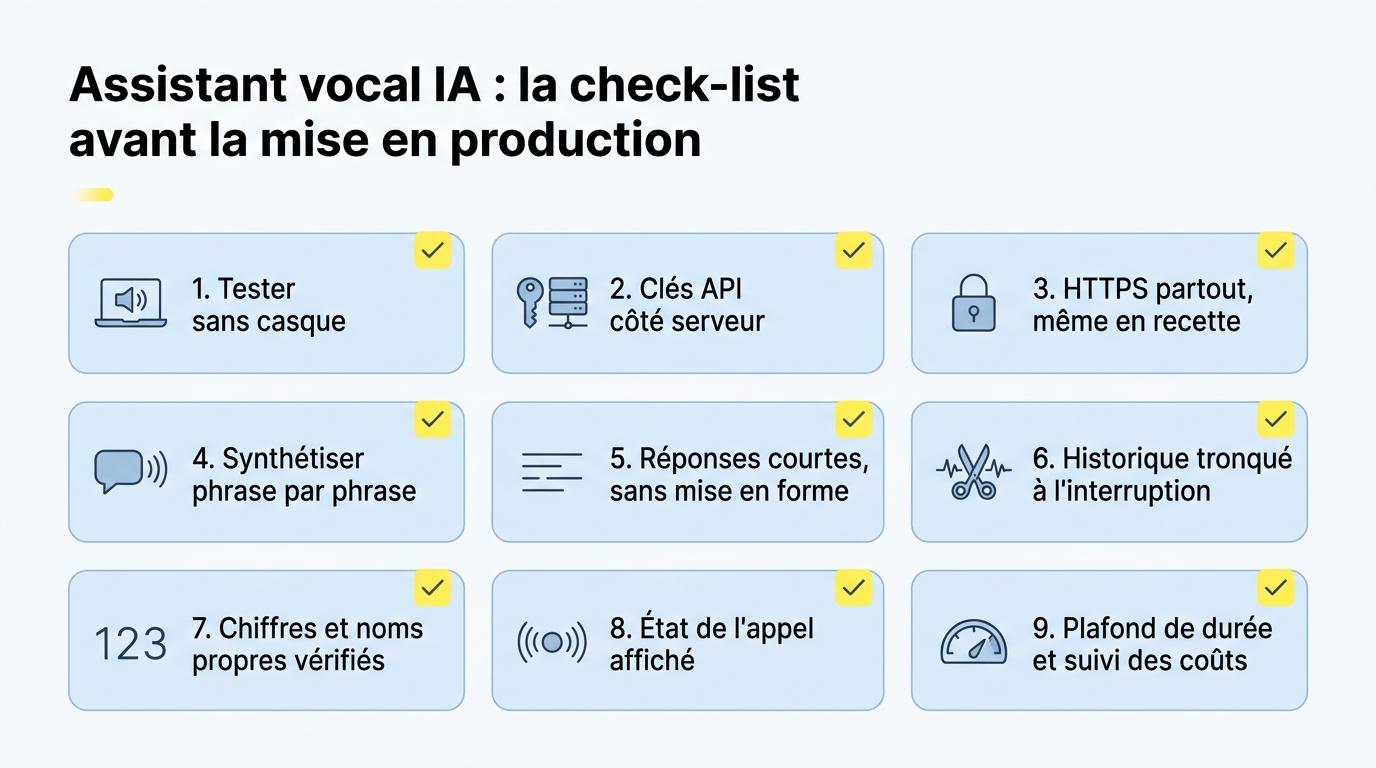
Les mêmes erreurs reviennent souvent sur les premiers prototypes vocaux. Corrigez-les avant la mise en production :
- Testez sans casque, sur des ordinateurs portables et des téléphones : l’écho n’apparaît qu’avec les haut-parleurs.
- Gardez les clés API sur votre serveur ou passez par des clés éphémères, car toute clé envoyée au navigateur peut être récupérée.
- Servez la recette en HTTPS, sinon le micro reste inaccessible.
- Envoyez chaque phrase à la synthèse vocale dès qu’elle est écrite, sans attendre la réponse complète.
- Demandez au modèle des phrases courtes et sans mise en forme, car une liste à puces, un lien ou un tableau ne se prononcent pas.
- Tronquez la réponse dans l’historique quand l’utilisateur interrompt l’assistant.
- Vérifiez comment la voix prononce les montants, les dates, les sigles et les noms de vos produits.
- Affichez l’état de l’appel, surtout pendant la réflexion et la reconnexion.
- Fixez une durée maximale par appel et suivez la facture de chaque fournisseur dès les premiers jours.
Intégrer un assistant vocal IA dans votre produit
Une démo d’assistant vocal IA tient en quelques dizaines de lignes de code. Pour une conversation fiable, comptez plutôt des semaines de réglages sur la fin de phrase, les interruptions, l’écho, la prononciation, les coûts et la confidentialité. Le pipeline STT, LLM et TTS reste le choix par défaut pour un produit en production, parce qu’il laisse choisir chaque fournisseur et limite la facture. Le modèle speech-to-speech sert surtout les produits où le ton de la voix compte autant que les mots.
Lonestone, agence fondée en 2014 à Nantes, a travaillé pour plus de 200 clients avec des ingénieurs qui ont pour la plupart entre 10 et 25 ans d’expérience. Elle conçoit des agents IA et des assistants sur mesure pour les PME et ETI, intègre des interactions vocales dans les logiciels des éditeurs et maintient Micdrop. Pour valider un cas d’usage vocal avec de vrais utilisateurs avant de tout construire, un POC suffit en général.
Questions fréquentes
Qu’est-ce qu’un assistant vocal IA ?
Un assistant vocal IA est un logiciel qui écoute une personne au micro, comprend sa demande grâce à un modèle de langage et lui répond à voix haute. Il enchaîne en général une transcription (speech-to-text), un modèle de langage qui peut appeler des outils métier, et une synthèse vocale (text-to-speech). Certains modèles, dits speech-to-speech, font ces trois étapes dans une seule session. Les agents IA vocaux vont plus loin en menant toute une conversation, par exemple un entretien.
Combien coûte un assistant vocal IA à l’usage ?
Le coût d’usage se calcule à la minute de conversation. D’après les tarifs publics de septembre 2026, une minute partagée entre l’utilisateur et l’assistant coûte environ 0,048 $ avec le modèle speech-to-speech gpt-realtime-2.1 d’OpenAI, 0,016 $ avec un pipeline de petits modèles OpenAI et 0,027 $ avec une chaîne européenne Gladia, Mistral et Gradium. Le développement s’ajoute à ce coût d’usage. Le prix d’un agent IA sur mesure dépend surtout des intégrations et du niveau de fiabilité visé.
Quelle latence viser pour un assistant vocal ?
Un assistant vocal paraît naturel quand il répond en environ une seconde après la fin de la phrase de l’utilisateur. La plus grande part de ce délai vient souvent de l’attente du silence qui confirme la fin de la phrase, devant le modèle de langage. Une transcription en streaming, une synthèse vocale lancée dès la première phrase et un détecteur de fin de tour réduisent le plus ce délai.
Faut-il WebRTC pour un assistant vocal dans une application web ?
Pour un navigateur qui parle à un serveur, une WebSocket suffit et évite d’exploiter des serveurs STUN, TURN et média. WebRTC se justifie pour les appels à plusieurs participants, la téléphonie, la vidéo ou des utilisateurs sur des réseaux mobiles faibles.
Un assistant vocal IA peut-il être conforme au RGPD ?
Oui, à condition de traiter la voix comme une donnée personnelle : informer l’utilisateur, limiter la conservation de l’audio et des transcriptions, et choisir des fournisseurs dont l’hébergement convient aux données traitées. Un pipeline permet de monter une chaîne entièrement européenne, avec Mistral, Gladia et Gradium par exemple, ou de faire tourner les modèles sur ses propres serveurs. Le choix entre ces options suit les mêmes critères que l’hébergement de toute IA.
Peut-on ajouter un assistant vocal à un logiciel existant ?
Oui. Un assistant vocal se branche sur un logiciel existant par un composant côté navigateur, qui gère le micro et la lecture, et par un service côté serveur, qui orchestre la transcription, le modèle et la voix et appelle les API du logiciel. Lonestone réalise ce type d’intégration IA dans des logiciels existants et maintient Micdrop, une bibliothèque open source en TypeScript dédiée aux conversations vocales temps réel.